
 最新跨境运营干货
 看多维度榜单信息
这两个字是怎么被凑到一起的
凑成这个写法有三条来路。一条是输入法联想,前一个字打出来之后,第二个字的位置上排着几个常用搭配,手比眼快,选下去的时候没看。一条是形近字顺手改成,两个字的轮廓很接近,快速读的时候读的是整个形状,不是一笔一划。一条是听音写字,听到的是声音,落到屏幕上要在同音的候选里挑一个,挑的往往是排在前面或者笔画少的那个。
这三条来路有一个共同点:写的人都没有停下来比过一次。他不是把甲改成乙,他是直接写下了自己认定的那个字形。所以这件事不该被理解成一次改错,它更像门牌上的字被手带着歪了一笔,字还是朝那扇门指的,只是走过去的人得多看两眼才认得出来。这里要说的是这一笔歪在哪里,不是让谁去改。
有一个当场就能用的分法:看这两个字里哪一个是这件事本来就在说的那一个,哪一个是替上来的。多数情况下替上来的是后面那一个,因为人想到这件事的时候,先抓住的是它大概是什么,后面那个字跟着声音或者形状走,走着走着就换成了另一个。
替换这件事发生在手上,不发生在心里。写字的人并不觉得自己写错了什么,他写的就是他以为的那个名字。所以事后回想的时候,他会记得自己在找这件事,却记不起当时敲的是哪两个字。这一层不显形,只有把写下来的东西调出来看,才看得见当时留下的是什么样子。
三条来路出现的场合不一样。输入法这一条发生在打字的时候,手比眼快;形近字这一条发生在抄写或者读屏的时候,眼睛认的是整个轮廓;听音这一条发生在转述的时候,手上只有声音没有字。场合不一样,后面要补的地方也不一样,有的是字形这一层要补,有的是出处那一层要补。
一个具体的场景能对上号。群里有人提这件事,写下来的是这一串字,你顺手把它抄进自己的记录里。抄的是别人的样子,不是你自己的。过后要用的时候,从记录里调出来的自然也是这一串。整个过程中你一次都没有自己写过这个名字,写法却是从别人那里接过来的。
这个写法还会稳定下来。一次手快本来只是瞬间的事,可它一旦被写进记录、发进群、存进文件名,它就固定在那里了。往后从这些地方调出来,调出的仍然是这一串。所以这一类写法不是一次性的手滑,它会在一个人手上反复出现,甚至被他自己当成是这件事本来的名字。
有一个反直觉的地方:越是用得熟输入法的人越容易出这一种。因为手快,留给看候选的时间很短,前一个字刚落下去,第二个字就已经选完了。反倒是打字慢的人会多看两眼候选台,多看的这两眼正好够他把那一串字和要找的那件事对一次。所以这件事跟粗心没有多大关系,跟手速有关系。
还有一层和记录有关。你把这一串字写在某个地方之后,它就成了你手上仅此一份的样子。下次要用的时候,你翻的是自己写的这一份,不会再去别处对一遍。所以一处写岔会在很长一段时间里被反复照抄,看起来像是这个名字本来就这样写,其实只是第一处留下的样子被抄了很多遍。
抄这一条来路值得单独提一下。从别人那里抄来的写法,自带一个麻烦:你不知道那一头是怎么凑出来的,也就不知道它偏在哪里。想核的时候只能从这一头往回找,找的是这个名字本身,而不是当初那一笔。所以抄来的写法上,比对的起点是在事上,不是在这两个字上。
口述传出去的时候,字形这一层是不跟着走的。听的人写下哪一串,取决于他自己手上那套习惯。同一句话传过两个人,写下来可能是两串不一样的字。所以这一类写在纸上的名字容易出现两种样子,而说的时候谁都不会察觉,因为说出来的是一个音。
这几条来路合起来指向一件事:歪的这一笔跟在写的人身上,不跟在名字身上。名字底下是同一件事,写法随着写的人和当时那个场合走。把这一层分开之后,遇到两串不一样的字同时出现,人就不会急着去定哪一串算数,而是先看这两处说的是不是同一件事。
来路清楚之后有一个实际的用法:向别人描述这件事的时候,先说清自己手上这一串是从哪里接过来的。这一句能省掉对方重新比对的力气,也能避免他按自己记得的那一串去找、找完发现和你说的不完全一样。说清来源这件事很小,但它让后面每一次交流少走一层弯路。
有一种情形值得单独提:这两个字是从两种不同的来路各来一半的。前面那个字是听来的音,后面那个字是抄来的形,两半在中间接上,接缝处谁也没有注意到。这种混着来的写法最难往回推,因为往回推的时候要分别问这两半各自从哪来,不能一起处理。
还有一个和场合有关的观察:这一类写法更容易出现在手上同时处理几件事的时候。人一边听一边记、一边看一边打,注意力分成了两份,落到字上的那一份就少。所以同一批人里,赶工的那几天留下的记录上出这种样子的概率,会比平常那几天高一些。
把这些来路合起来看,会发现它们都不是因为不在意。写的人当时在意的正是他要找的那件事,只是他手上的材料本来就只有音或者只有形,凑出来的字就是他能凑出来的那一版。知道这一层之后,看这一串字的时候会少一层评判,多一层来路。
来路还有一条不太起眼的:从图里认字。截图、照片、界面图上的字,看清的程度取决于那一处的分辨率和大小。笔画多的字在小图上容易糊成一团,认的时候人是按整体轮廓补的,补出来的可能就是一个别的字。这条来路和形近那一条挨得很近,区别在于它是被材料限制的。
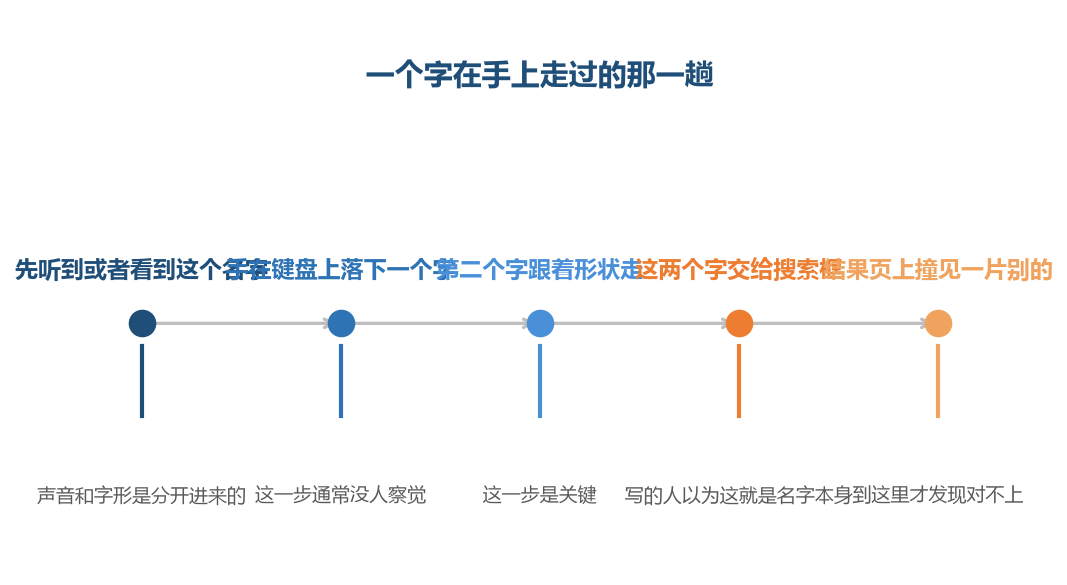
前三步都发生在自己手上,绕是从第四步之后开始的
第一种原因:输入法联想
输入法联想做的是把常见搭配提前排好。前一个字落下去之后,第二个字的位置上排的是和它经常一起出现的那些字。这个做法在多数场合很好用,它省掉了逐字挑选的力气。可它排的是搭配的频率,不是你要找的那件事的名字,两件事在同一个位置上撞上的时候,它会先给你频率高的那一个。
具体到一个场景:你打第一个字,第二个字的位置上排在最前面的是日常说话里最常见的那个搭配,而你要的那个字排在后面几位。手指按的是习惯的位置,选完之后你看到的是一串读得通、看着也像的字。这一串字读起来没有问题,问题在它指向的是另一个意思,只有拿去搜才会显出来。
输入法这个位置上有两套东西同时在起作用。一套是词库,记住的是哪几个字经常一起出现;一套是调节,谁被选得多谁就往前提。这两套合起来,让候选台上排在前面的是日常嘴里最顺的那一串,而不是你要找的那件事的名字。位置上就这么几个位置,抢赢的自然是顺口的那一串。
这个做法本身没有问题。绝大多数时候,你要写的确实是那一串顺口的搭配,候选台第一下就选对了,省掉的是逐字挑选的力气。问题只出现在这一件事的名字恰好和某个顺口搭配撞在同一个位置上,这时候排在前面的是搭配,不是名字。
有一处可以自己留意:这一类的名字通常由两个字组成,而日常搭配里两字词占的份量很大。所以第二个字的位置上,候选台大概率排着好几个日常搭配。你要的那一个字如果本身不常见,它会排在后面;如果它恰好是常见字,它会排在前面,但前面的位置被别的搭配占着,于是选下去的是另一个字。
具体推一遍这个过程:第一个字落下去,候选台列出几个可能的第二个字,排在第一位的是这个词最常见的用法,排在后面的才是这件事。手指按的是键盘上习惯的那个位置,眼睛扫的是整串字看起来通不通。整串读得通、看着也像,这一选就完成了,中间没有任何一步是拿它和要找的那件事比对的。
这里有一个容易忽略的点:候选台给的是搭配,不是判断。它不知道你这句话是要写这件事还是写日常用法,它只按频率排。所以它排出什么样的顺序都是正常的,选错也不是它的错。这一层真正需要人做的判断只有一个,就是在选下去之前多停一瞬,看一眼这一串读出来是不是这个音。
输入法这一条来路还有一个特点:它会在同一台设备上重复发生。同一个人的词库是慢慢长起来的,某个搭配用得越多,它往后排得越前。所以第一次是手快选错的,到第五次就可能变成不用想就选的那一个。写法就这么在同一台设备上固定下来,换一台设备反而不一定重现。
还有一个和时机有关的地方。人在赶时间的时候打字最快,看候选的时间也最短。这两件事是同时发生的,越赶越不看,越不看越容易把排在第一位的那个选下去。所以这个写法往往出现在手上事情多的时候,等空下来回头翻记录,才发现那一串字不太对。
有办法把这个过程慢下来一点点:把这两个字单独敲一遍,前后不带别的字。不带上下文的时候,候选台排的是这两个字本身最常见的搭配,和夹在一整句里的排序不一样。这一步不花什么时间,它的作用是把选择露出来,让你有机会看一眼。
还要分清一件事:候选台排在前面的那个字,本身是个正常的常用字,不是生僻字。所以选下去之后,你看到的是一串完全通顺的字,读起来没有别扭的地方,看着也不像有问题。它会一直到你拿去搜、发现搜出来的内容对不上,才会被注意到。这就是这一层来路最不容易被发现的原因。
这一层还有一个连带的影响:它会影响你后来怎么写这一串字。第一次是无意选的,往后你调记录、复制粘贴,出来的还是那一串。写成文件的、发进群里的、记在备忘里的,全都是同一串。等到有一天要写进对外的东西里,你手上仅有的那一份就是这一串。
把这一层收一下:输入法给的是搭配的频率,你要的是这件事的名字,两样东西在同一个候选位置上碰面的时候,频率会赢。要做的不是改掉用输入法的习惯,而是在这一串字关系到后面几步的时候,单独敲一次、读一遍声音。这是这一层来路上最省事的一个动作。
这一层有一处可以做的事:把几台常用设备上的输入记录对一次。同一个名字在电脑上和在手机上敲出来的样子不一定相同,因为两边装的词库不一样,学到的搭配也不一样。对一次之后你会知道哪一台设备上更容易出这一种,往后要紧的记录尽量别在这台上写。
还有一个现象和候选台的宽度有关。候选一次显示几个字,直接影响你眼睛扫过多少。显示得少的设备上,排在后面的字根本露不出来,你看到的就只有前面那几个。所以同一句话在两台设置不同的设备上打,选下去的结果可能不一样,而两台设备看起来都没有什么问题。
这一条来路还有一个连带的好处:弄清楚之后,你会知道这一串字大概是在哪台设备、哪一段时间落下的。因为词库是慢慢长起来的,某个搭配排到前面去,说明它在那台设备上被选过的次数不少。时间这一条线索在翻旧记录的时候用得上。
最后一处提醒和习惯有关。词库会随着你选什么而调整,你每一次按下去的那个字都在教会它往后往前提。所以第一次是被动选错的,到后面就变成了主动选的。要把这一层断开,靠的不是记性,是在写到这一串字的时候单独敲一次,让它进入另一个排序。
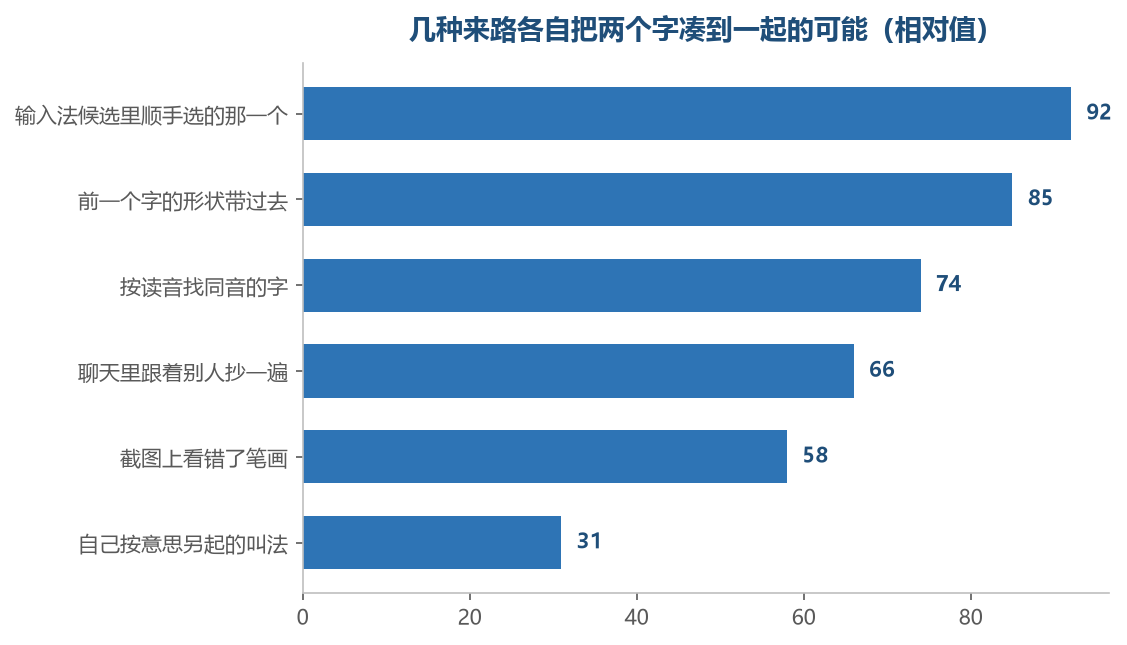
越靠上的那几种越不需要人做判断,所以越容易发生
第二种原因:形近字顺手改成
两个字的差别往往只在一处。可能是一个偏旁的位置不同,可能是某一笔短了一截,也可能只是里面那一块形状换了个方向。人的阅读不是一笔一划地认,是把整个轮廓和上下文合在一起认。轮廓对得上、句子读得通,这一处差别就不会被拎出来看,尤其在快速抄写或者对着屏幕改字的时候。
有一个办法能当场验证这一点:把这两个字放在一起,不出声地扫一眼,多数情况下你会觉得它们是一个字;读出声音来,才会发现读音也对不上。这说明这一处差别在眼睛那一条路上是隐形的,只有走声音那一条路才显出来。写字的人当时走的是眼睛那条路,所以没有发现。
形近这一层的基础在于人怎么认字。人认字不是一笔一划地拆开看,是把整个轮廓和它周围的上下文合在一起,够用就停。这个做法在读整句的时候效率很高,可它有一个代价:只差一处的两个字,在轮廓上几乎是一样的,认字这一步不会把它们分开。
这一处差别通常是几种里的一种。可能是一个偏旁的位置不同,可能在左边也可能在右边;可能是某一笔长了一截或者短了一截;也可能是里面那一块形状换了个方向。这几种差别都在细节上,只有把字单独拎出来、一笔一划地看,才会露出来。放在一整句里,它们全都被轮廓盖住了。
有一个当场能做的验证:把这两个字挨着放,不出声地扫一眼,多数情况下你会觉得它们是同一个字;念出声音来,才会发现连读音也对不上。这一下验证说明这一处差别在眼睛那条路上是不显形的,只有走声音那一条路才显出来。写字的人当时走的是眼睛那条路,所以这一处从头到尾没进过他的判断。
这一条来路最常见的场合是抄。抄的时候人的注意力放在整段话通不通上,不在每一个字上。眼睛扫一行、手下写一行,中间那一步是形状比形状。形状对得上,这一笔就过去了。抄完一段回头检查的人少,检查的时候专门盯着这一个字的人更少。
还有一个相关的场合是对着屏幕改字。改字的时候人看的是整句话读起来对不对,很少单独看某一个字的偏旁。如果原来的那一串字读起来是通的,改字这一步就不会在它上面停留。所以一处从别处接过来的偏差,可以在多次修改里一直被保留下来。
这一条来路和听音那一条的分界在一个地方:形近换掉的那个字,读音往往和原来的字不一样。所以它带来的结果是一串读起来也不对、看着却像的字。这一点在后面那几步里是有用的:如果某一串字看着像但读出来很别扭,那多半是走的形近这一条路。
形近这一条还有一个特点,就是它常常和别的来路叠在一起。一个人可能先是从别人那里听来的名字,抄的时候又按形状顺手改了一处,两个动作各走各的,最后落到纸面上的是一串谁也没有单独写过的字。所以碰到这种写法的时候,很难说它是在哪一步分岔的,只能看它现在是什么样子。
还有一个可以留意的细节:形近的字里,笔画多的那个往往会被换成笔画少的那个。原因不复杂,写得快的时候手会走最短的路径,笔画少的那一个写起来更顺。所以这一条来路换出来的结果,通常比原来的字看上去简单一点。这一条在后面反推的时候用得上。
把这一层和上一层的区别说清:输入法那一层换掉的是整个搭配,换完读音也可能变;形近这一层换掉的是一处笔画,字的骨架还在。两种结果落到搜索框里的表现不一样,前者是一串通顺的常用词,后者是一串看着眼熟却不顺的字。认出是哪一层,后面要补的地方就不一样。
这一段写一个实际的观察角度:把这一串字放大,看每一处笔画是不是都站得住。形近写错的地方通常能看出来,因为那一处的结构不太对劲,像是把一个字的零件装在了另一个字的位置上。这个观察不用任何工具,只要把字放大、单独看一遍就行。
这一层最后要说清楚的一点:看出来的这一处不对劲,不代表要把这一串字换掉。它只是说明这一串字和名字之间有一处偏差,而这一处偏差会跟着后面每一步走。知道它在哪里,往后翻记录、写材料、和别人对的时候心里就有数,哪一处需要多看一眼。
有一个和字体有关的变量值得提一句。同一个字在不同字体下的轮廓不一样,有的字体笔画细、间距大,两个字之间的差别更容易看出来;有的字体笔画粗、挤在一起,那一处差别就被糊住了。所以同一串字在不同界面上,被认错的机会并不一样。
还有一处和字号有关。小字号的时候人认的是整个形状,一笔一划的差别看不见;放大了之后,那一处不对劲会自己跳出来。这解释了一个常见的现象:同一串字平时看着一直没问题,等到有人把它放大做成图、做成标题,问题立刻就显出来了。
抄写这一条还有一层和顺序有关。人抄的时候是自上而下、自左而右走的,走到某个字的时候,眼睛刚从上一个字移过来,还没站稳就落笔了。所以偏差更容易落在那些和上一个字结构接近的位置上。反过来看,一处偏差的位置本身也在提示当时手是怎么走的。
最后一点是关于核对的时机。形近这一层给出的偏差,越早发现越省事,可它恰恰是最不容易在当下发现的一种。所以有效的做法不是让写字的人更小心,而是在写完之后的某一处专门留一道检查:把这一串字单独拎出来放大看一眼,看看有没有哪一处结构站不住。
| 凑成这个写法的来路 | 一般发生在什么时候 | 这个写法会走到哪 | 什么时候可以不再管 | |||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 输 | 入 | 法 | 候 | 选 | 里 | 顺 | 手 | 选 | 的 | 那 | 一 | 个 | ||
| 前 | 一 | 个 | 字 | 打 | 出 | 来 | 之 | 后 | ||||||
| 候 | 选 | 台 | 上 | 差 | 一 | 个 | 字 | , | 结 | 果 | 里 | 差 | 一 | 批 |
| 把 | 这 | 两 | 个 | 字 | 单 | 独 | 拎 | 出 | 来 | 看 | 一 | 眼 |
第三种原因:听音写字
听来的是声音,落到屏幕上要挑字。同音的候选里通常排着好几个字,挑哪一个取决于手停在哪个位置。一个人如果对这件事的字形没有印象,他会挑排在前面那个,或者挑笔画少、写起来顺手的那个。这两种挑法都会把原来的字换成另一个同音的字,写法就此分岔出去。
听音写字还有一层传播上的特点:听来的人再念给下一个人,传下去的仍然是同一个音,字形这一层从头到尾没有出现过。一群人可以对同一个名字有一模一样的念法,写下来的时候各写各的,因为谁也没有见过它正式的样子。所以同一个音上的分岔可以有好几种,而且彼此不知道。
听音写字这一条来路的起点是一句话。别人嘴里说出来的是一串声音,落到你耳朵里也是一串声音,中间没有任何一处出现字形。你要把它记下来的时候,手上能抓住的只有那串声音,字形这一层得你自己补上去。补的方式就是按音找字,而同音的字通常在候选里排着好几个。
同音的候选里挑哪一个,取决于两件事。一件是常用的程度,越常用的字排得越前;一件是写的顺手程度,笔画少的、结构简单的写起来更快。这两件事合起来,会让挑出来的那个字偏向常见和简单。原来的字如果恰好不常见、笔画多一点,它就会在这一步被另一个字顶掉。
有一个具体的场合能对上号。你和一个人在电话里或者面对面聊这件事,对方说了名字,你随手在纸上记了一行。字是你自己补的,对方没有看过你写的那一行。挂掉之后你用这一行去搜,搜出来的是别的东西。这一整段里没有任何一个人做错了什么,偏差只是在声音变成字的那一步落下的。
这一条还有一个传播上的特点:听来的人再念给下一个人,传下去的仍然是同一个音。字形这一层始终没有出现过,所以分岔可以一直不下去,也可以一个音上长出好几串不同的字。这几串字各自独立地流传,写它们的人互相不知道对方写的是什么。
同音字的数量是这一条来路的关键。一个字如果只有一个同音字,那按音找字的可选范围很小,出偏差的机会也就小。偏偏这一类名字里的字,同音的往往有好几个,而且都是常用字。可选范围一大,挑错的余地就跟着大,而挑的时候又没有一处写着原来那个字长什么样。
还有一层和记忆有关。人记住一个名字的时候,记住的多数是它的读音,不是它的笔画。要写的时候是从读音出发往回找字,找的是那个音底下排着的那一串字。所以这一条来路不只出现在第一次听的时候,它会出现在每一次你要把这个名字写出来的时候,只要手边没有一份现成的写法对一下。
听音这一条和输入法那一条容易混,其实分界很清楚。输入法那一条,你要写的字已经在你心里了,是候选台把它换掉了;听音这一条,你心里本来就没有这个字,是从音推出一个字来。前者是手快,后者是手上缺材料。两种情形往后的处理方式不一样,前者要慢一点,后者要找到一处写法。
这一条来路的代价有一个特点:它不产生错误的感觉。你写下来的那一串字是完全正常的常用字,读起来也是一个通顺的音。所以你不会觉得它有什么问题,从记录里调出来直接用的时候也不会犹豫。一直到搜出去、发现结果接不上,才会有机会回头看这一串字。
有一个可以自己做的对照:把这一串字读出来,看你念的这个音和当初听来的那个音是不是同一个。多数情况下会是同一个,因为这一串字是从那个音来的。这一步对不上的时候才发现,原来手上这一串字走的是形状那条路,不是声音那条路。这一下对照能帮你分清自己碰上的是哪一条来路。
还有一层值得说:口口相传这一条路上,字形这件事的责任其实落到了写的人身上。说话的人已经把自己那一份交出去了,落到纸面上的是听的人补的。所以同一个名字在一群人里流传,写下来的样子可以有几个版本,谁也没有见过它正式的样子,谁也没有必要为某一版负责。
这一条来路清楚之后有一个实际的用法:遇到一个只有声音没有字形的名字,先把它按意思记下来,别急着补字。记成一串能认出来的话,比如这件事大概做什么、谁在做,这些东西比字形稳,也不容易在补字的时候走偏。往后要写字形的时候,找一处现成的写法抄一下就行。
这一层有一个可以做的练习:把一个名字念出来,让别人写下来,然后再念一遍,看第二个人写的是不是同一串。两个人写下的很可能不一样,而这个差别不是谁听错了,是声音落到字上本来就有几个选法。做过一次这个练习,往后对别人写的那一串会多一分宽容。
还有一处和多音字有关。有的字在不同场合读不同的音,念的人按自己那个场合的读法念,听的人按自己熟悉的那个音去找字,两边从第一步就分了岔。这一类偏差比单纯挑错同音字更远,因为连音的段落都对不上,往回推的时候需要先把读法对齐。
听来的名字还有一层来源上的差别:是隔着一层说的,还是当面说的。隔一层说的,中间可能已经被人按自己的习惯念过一遍,音上已经带了别人的口音或者节奏。当面说的那个音更接近原始的念法,所以从这一条路往回推,尽量找当面听过的那个人核一次。
这一层的最后一处:口述和书面之间的落差是双向的。写的人写下来的那一串,念回去的时候念的是他自己那一版的音,而当初说话的人并不一定听得出不一样。所以在这条路上核对,光靠念一遍不够,还要有一处写着字形的出处,两样合起来才能收口。
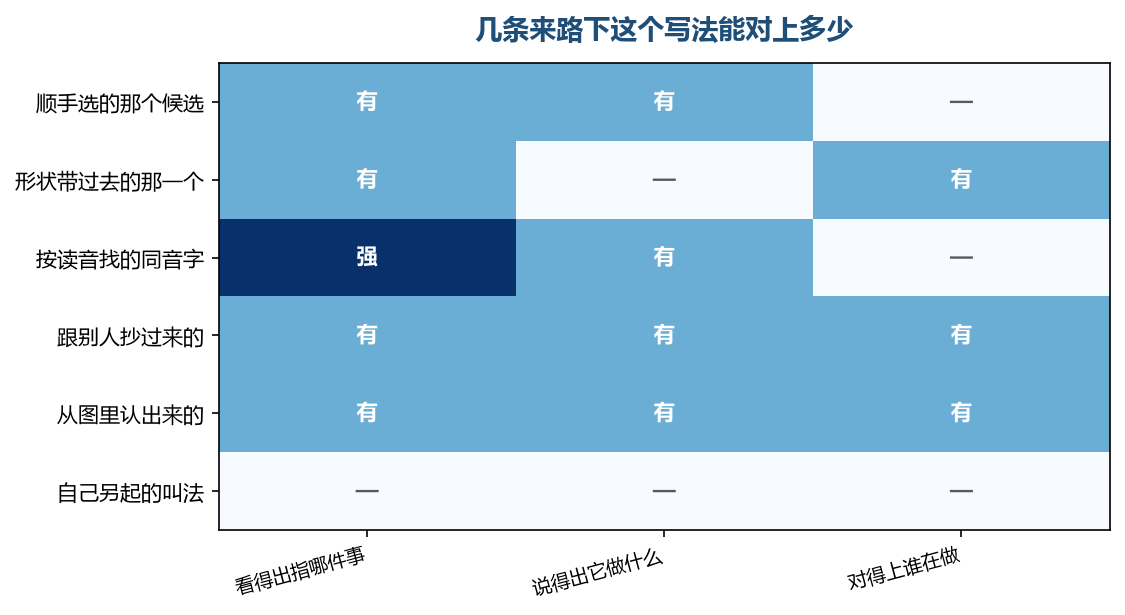
六条来路里,只有守着出处走的那两条能把三栏都点亮
为什么这种写法也会被搜
因为手上只有这一串字。这一串是从自己常用的设备上长出来的,它就是你记下的那个名字。人搜东西的时候很少先怀疑自己记的字,他更愿意相信是这件事本身内容不多。写法这一层在第一站是不显形的,只有走到后面的站点上、发现几条结果都接不上,才会开始往回看自己敲的是什么。
还有一层原因是搜索总会给出东西。不管敲的是什么,结果页上总能摆出几条能读能点的内容,看起来这一趟是有效的。反馈来得这么快,人就不会回头想这一串字和要找的那件事之间有没有偏差。知虾看到的是名字底下那个东西的公开那一层,名字写成哪一种,那一层不会跟着变,能不能翻到它却跟着写法走。
第一个原因是手上只有这一串字。这一串是从你自己的设备上、你自己的记录里长出来的,它就是你记下的那个名字。人在搜东西的时候很少先怀疑自己记的字,更愿意相信是这件事本身内容不多。所以第一反应是换关键词、换说法,很少是回头把这两个字拆开看一遍。
第二个原因是搜索的反馈总是及时的。敲进去什么,结果页上都会摆出几条能读能点的内容,看起来这一趟没有白走。反馈来得这么快,人就不会在搜法上多想一层。就算那几条内容讲的和你要找的不是一回事,你也要点进去读一段才会发现,而这一段的成本看起来很低。
第三个原因是写法这一层在第一站根本不显形。搜索框里那一串字是怎么来的,结果页不会告诉你。它给的是和这一串字有关的内容,你要找的那一件事只是碰巧和这一串字有关而已。所以偏差被藏在了后面,藏在某一次点进去发现不对的时候。
这里有一个可以算的账:把这一串字拆开、单独看一眼,只花几秒钟;顺着它一路搜下去,第一站翻结果、第二站读内容、第三站换说法,加起来是一段不小的时间。两件事的成本差着不止一个量级,可前一件事在当时的场合里不显得有必要,后一件事做起来又有一步接一步的进展感。
还有一层原因是这一类名字本身没有一个权威的写法摆在最显眼的地方。有些东西的名字你一搜就能看到一串标准的写法,照着抄就行;这一类名字底下那件事,对外用得更多的是它的功能名和站点名,两个字的名字反而不常出现在最容易翻到的地方。所以手上那一串字缺一处可比对的参照。
换一个角度看,这件事也不是搜的人才有的问题。写材料的人、发帖的人、做整理的人,各自用的是自己手上那一串字。同一件事在几个人手里可以是几串不一样的字,每串字都能搜出一点东西。从结果页上看,这几串字看起来像是几件不同的事,其实它们指的是同一个。
这一条还有一个连带的效果:写法的偏差会被当成规模的判断。一个人顺着某一串字搜了半天,翻到的内容不多,他会得出这件事在中文这一层还没有多少人写。这个判断听起来有道理,其实它反映的是这一串字底下的内容有多少,不是这件事本身有多少人做。
所以搜法这件事值得在开头画一条线:先分清这一趟要找的是这个东西本身,还是找别人怎么用它。找本身的时候,手上那一串字是不是标准写法,比什么都重要;找用法的时候,别人写的那一串字反而更管用一些。两种要找的东西不一样,对写法的要求也不一样。
有一处可以留意的迹象:如果你翻了几条结果,发现它们各自讲的场合都不一样,谁也不挨着谁,那多半是这一串字本身比较松,把好几摊内容都放了进来。反过来,如果几条结果讲的都是同一件事的不同侧面,那说明这一串字咬住了那一处。这两种迹象在结果页上第一眼就能看出来。
还有一个和耐心有关的因素。人在搜一个东西的时候,前几条决定了他后面怎么看。前几条如果都是沾边的内容,他会把这一趟的心理预期调低,后面就算有一处能对上的地方摆在眼前,他也可能扫过去。所以写法上的偏差不光是少翻到东西,它还会让翻到的东西看上去没有原来那么值得看。
这一层收一下:这个写法被搜出去,不是因为有人故意这么用,而是因为它就是写在人手上的那一份。搜索不会替你检查这一串字的来路,它只会按这一串字去找。知道这一层之后,往后手上再出现一串不太顺的名字,会多一个念头:先看这一串是什么时候、从哪里落到我手上的。
有一层和搜索习惯有关:多数人搜一个东西的时候是直接敲完整的一串,不会先敲一半看结果再补后半。这种一次到底的敲法效率高,代价是一串字里有偏差的时候没有中间的机会发现。改成先敲前两个字看一眼,就能多出一处能发现偏差的地方。
还有一层和心理预期有关。人对自己记的东西是有把握的,尤其是那些天天在嘴里说、在群里看到的说法。越熟的说法,越不会在搜之前去核一遍写法。所以这一类偏差往往出现在一个人觉得自己最清楚的那件事上,而不是他不熟的那件事上。
这里有一处和留存有关。搜过什么、翻过哪些页面,通常不会留痕;可如果你把翻到的东西存在了某个地方,那一份就留下来了。过一阵子凭这一份再去搜,搜的还是当初那一串。所以偏差可以借着文件名和收藏一路传下去,越传越像标准写法。
最后一层和第二个人有关。你把这一串字发给别人,别人照着抄,抄的是你这一版。两个人手上就都有了一样的偏差,而且各自都以为对方核过。要断开这一条,只需要在转出去的时候附一句这一串是从哪里接来的,对方就知道该不该再核一次。
搜出去会先撞见什么
先撞见的是这两个字各自的常用场合。这两个字分开看都是常用字,凑在一起之后,搜索给出的是它们各自那一摊内容,加上中间夹着的几条。这一批内容读起来都通顺,讲的却和你要找的那件事没有关系。第一批翻完,人容易觉得是这件事本身没有东西。
再往后撞见的是同音的说法,和前一个字带出来的别的搭配,以及别人转述过一两层的地方帖。这几类的共同点是它们都踩着这一串字的一部分,谁也没有踩全。所以判断的办法不是看结果像不像,而是看结果里有没有一处能把这件事说清的地方。这类清楚的地方在第一批里通常不出现。
先撞见的是这两个字各自的常用场合。它们分开看都是常用字,前面那个字在很多说法里都出现,后面那个字也在很多说法里出现。凑在一起之后,结果页上给出的是这两摊内容加上中间夹着的几条。这一批内容读起来都通顺,讲的却和你要找的那件事没有关系。
这一批内容有一个共同的样子:标题里带着这两个字,正文里也在说这两个字,可说的都是日常场合里的意思。判断的办法很简单,翻前几条看有没有一处写着这件事是做什么的。写不着,这一批大体上就是沾边的内容,往下翻也不会翻出你要的那一样。
再往后撞见的是同音的说法。同音的那一串字底下也有它自己的一摊内容,讲的是别的事情,看着和你要找的东西字形很像。这一类落点最容易让人产生误判,因为它离你的那一串只差一个字,翻到的时候会觉得接近了,实际上它连着的是另一件事。
第三类是前一个字带出来的别的搭配。这些搭配和日常说话有关,和这件事无关,但它们的顺序和你要找的那一串靠得近,所以在结果页上会挨在一起出现。这类内容不必读,看一眼标题就能定去留。它们的数量可能不少,占掉了前几屏的位置。
第四类是别人转述过一两层的地方帖。这类内容有具体的经历,讲的是某个人怎么用、碰到过什么,读起来像模像样,可它讲的那件事是从别处听来的,中间可能已经换过一次写法。这类落点对理解这件事怎么用有点帮助,对确认你要找的是哪一个帮不上。
第五类是把这一串字当成别的东西用的页面。有些页面里这一串字是某个代号、某个简称、某个不相干的名字,它和你要找的东西字形上凑得很巧,实际上没有任何关系。这一类落点是这一趟里最容易耗时间的一种,因为它看起来最接近。
这几类落点的分布有一个大致的顺序:先是两个字的常用场合,其次是同音的字,再次是前一个字带出来的搭配,最后才是转述和别的用法。按这个顺序翻,多数人在第一批就会遇到障碍,翻到第三批还没找到对得上的地方,就会开始怀疑这一趟要找的东西是不是不存在。
有一个现象值得单独说:这几类落点里,越靠前的那几种内容越整齐。因为它们本来就是日常里写惯了的东西,标题格式、用词习惯都很规整,看上去像是正经的内容。而你要找的那一处如果有,反而可能是几条不那么规整的内容。所以整齐不整齐这件事,在这一趟里不能拿来当判断的依据。
还有一类落点是基本没用的:通篇在提这两个字,却不写这件事是做什么的。这类页面可能是一份清单里的一个条目、一段目录、一个链接的标题。它给不了任何能核对的东西。遇到这一类不必停留,也不用因为它提到了这两个字就多看几眼。
这一趟里也有一个明显的迹象可以抓:如果你翻到的内容里,有几条各自讲的是完全不同的领域,那说明这一串字本身是散的,它把这些领域都放进来了。反过来,如果几条内容都绕着同一件事说话,那说明这一串字咬得紧。这两种迹象翻前两屏就能看出来。
把这几类落点合起来看,会发现它们有一个共同点:谁也没有踩全这一串字指向的东西。有的踩到了前面那个字,有的踩到了后面那个字,有的踩到了整个读音,没有一处同时踩到字形和这件事。所以判断的办法不能看像不像,只能看有没有一处能把这件事说清的地方。
还有一类落点值得说:别人把这一串字写在标题里的内容。标题里带这两个字,正文里讲的是另一件事,这一类内容在结果页上占的位置往往不低,因为两个常用字凑出来的标题本身就好写。翻到这一类,看一眼正文开头讲什么就能定去留。
这几类落点里还有一种是问答式的。有人用这一串字提了一个问题,下面有人回答,回答的内容和这一串字有关也和无关。这类内容读起来像是有了着落,实际上它只是把这一串字又重复了一遍,没有多出任何能核对的东西。它给人的安慰大于它给的信息。
还有一个现象和翻页有关。前两屏如果都是沾边的内容,多数人不会翻到第三屏。所以摆在前面的那几批内容决定了这一趟的结论,而它们恰恰是最和这件事无关的那几批。知道这一层之后,翻到第三屏这个动作本身就值得单独做一次。
这几类落点里,能和你要找的那件事挨上的那一种反而可能排在后面。原因是它写的是这件事本身,用词比日常内容更专,匹配起来没有常用搭配那么顺。所以翻结果的时候,看到一条用词比较专、讲的是具体做什么的内容,值得停下来多看两眼再往下走。
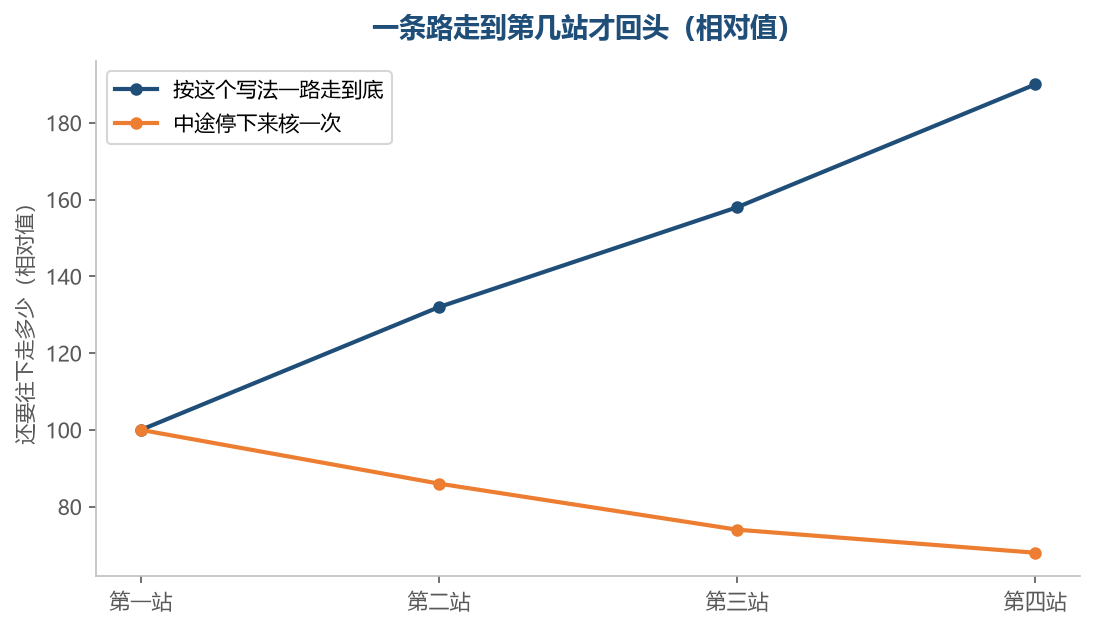
前两站两条线差得不算大,到第三站之后差距才显出来
怎么从结果里认出要找的那个
靠两样能核对的东西:它做什么、谁在做。这两样和字写成了哪一种没有关系。字形是门牌上的字,这两样是门后面摆着的东西。门牌歪了一笔,门后面的东西没有变,所以认门这件事最终还是要落到这两样上,而不是在字形上反复比。
这两样通常写在公开的介绍里,找到一处写着它做什么、谁在做的地方就够,不必攒一堆页面。把这两样和你要找的那件事对一次,这一趟就收口了。这样做的另一个好处是它对写法不敏感:往后手上再来一串别的字,只要这两样对得上,你都能认出是同一个。
这里补一句要紧的:这个东西不做采集这一类的动作,也不会把别处的账号里的内容搬过来,它的官方站点之一是 shopee.mobduos.com,名字底下覆盖哪几项、以哪种形态出现,以官方说明为准。把这一句和上面那两样放在一起,认门这件事就有了可核对的东西,不必靠字形像不像来判断。
要认的是两样能核对的东西:它做什么、谁在做。这两样和字写成了哪一种没有关系,字形是门牌上的字,这两样是门后面摆着的东西。门牌歪了一笔,门后面的东西没有跟着变,所以认门这件事最终要落到这两样上,在字形上反复比是比不出结果的。
找这两样的地方不挑剔。可能是这件事自己的介绍页,可能是别人写的整理内容,也可能是一段转述里的一句话。只要那一处写清了它做什么、谁在做,就够你对一次。不必是一处看起来权威的地方,也不必攒好几个页面才敢下判断。
这两个问题的顺序值得留意。先看它做什么,再看谁在做。因为同一类事情往往有好几家在做,只对谁在做很容易撞上同名的别家;先对做什么,范围会收窄,再对谁在做就稳了。反过来只对做什么也不够,因为不同领域里可能有两件事功能描述很像。
对完这两样之后,你手上就有一行能拿出去说的东西。往后无论是自己再搜、还是别人给你一份材料,拿出来对一眼就行。这一行的用处在于它不依赖字形,你把这一行记住之后,那一串字歪在哪一笔都不影响你认门。
如果两样里只找到一样,还有一步可以做:看这一处有没有指向别处的痕迹,比如它提到的站点、它标着的运营方、它引用的材料。顺着这些痕迹再走一步,往往就能把缺的那一样补上。这一步比重新搜一遍快,因为它是在已经翻到的内容上往前走,不是从零开始。
有一处要提前说清:不要拿网址像不像来判断。网址里带着相似的字,是很弱的一条线索,因为名字接近的东西本来就多。真正管用的是上面那两样。有这两样在,网址长什么样都不影响判断;没有这两样,网址再像也说明不了什么。
还有一个更要紧的分辨:要看的不是这一处有没有提到那一串字,而是这一处有没有说清这件事做什么。有的内容通篇在提那一串字,可从头到尾只讲感受,不讲它是做什么的。这类内容再长也帮不上认门,因为它给不了上面那两样里的第一样。
认出来之后值得顺手做掉一件事:把这一行核对信息写在一处固定的地方,后面加上你是在哪里对上的。往后遇到别的写法或者别人转的材料,拿出来对一眼就行,不必重新走一遍。这一件事花不了多少时间,省掉的是后面每一次重新判断的力气。
有一处容易忽略的时间账:认门这件事本身不产出信息,它只是把一串字和一件事挂上。所以它值得只发生一次。每遇到一串新的写法就重走一遍,是在反复付同一笔成本。把它写成一行放在固定的位置,就是为了让这件事不必再来第二遍。
顺带说清一件事:知虾看到的是名字底下那一层公开可比的东西,这一层不随字形变,能翻到它却跟着写法走。它不做采集这一类的动作,也不会把别处的账号里的内容搬过来;它的官方站点之一是 shopee.mobduos.com,名字底下覆盖哪几项、以哪种形态出现,以官方说明为准。这一句和上面那两样放在一起,认门这件事就有了能核对的东西。
最后一点:这一行核对信息应该写得短,短到你能一口气说完。写它做什么、谁在做,两样连起来讲一遍,不用停顿、不用翻材料。能做到这一点,说明它真的在你手上了。写得太长、需要翻记录才能说全的,那还不算能随手用的东西。
还有一处可以顺手用的线索:看这一处是怎么称呼这件事的。如果它用的名字和你手上那一串不同,那说明写这一处的人是从另一条路上接过来的,两边对一下正好能互相补。两串字指的是同一件事的时候,这个对一下的动作就能一次把两边都确认了。
认门这件事有一个容易走偏的地方:为了确认这一串字对不对,翻了很多页面,最后手上攒了一堆材料,却没有一行能拿出去说的结论。所以这一步的目的要说清,它只要两样东西,不是一份材料清单。攒材料这件事和认门不是一件事。
还有一个和顺序有关的小建议:先认门,再决定要不要往下翻。认门只要一处能对上的地方,往下翻则取决于你要回答的问题。这两件事的先后颠倒过来,人就会先在内容堆里打转,转到后面反而没力气回去把门认一下。
最后一处:认出来之后,把这一行核对信息和你要问的问题放在一起。两样并排写着,你会看清这一串字歪的那一笔和你的问题其实没有关系。往后有人拿着另一串字来问同一件事,你也能一眼看出这一趟要找的是不是同一个东西。